把 PDF 轉成 Markdown 給 AI 使用 —— ChatGPT、Claude 與大型語言模型
直接把原始 PDF、含噪訊的文字丟進大型語言模型(LLM),會明顯降低準確率、浪費高達 85% 的上下文 Token 預算,還會把表格與公式弄亂。把 PDF 轉成 Markdown 後,你會得到乾淨、語意清楚的多欄文件結構,Claude 3.5 Sonnet、ChatGPT(GPT-4o)與本地大模型都能原生理解。本篇完整工程指南說明如何用 AI 把文件轉成 Markdown,為何 Claude 與 LLM 在 Markdown 結構下表現更好,並教你為 AI 工作流準備高準確度的文件語料。
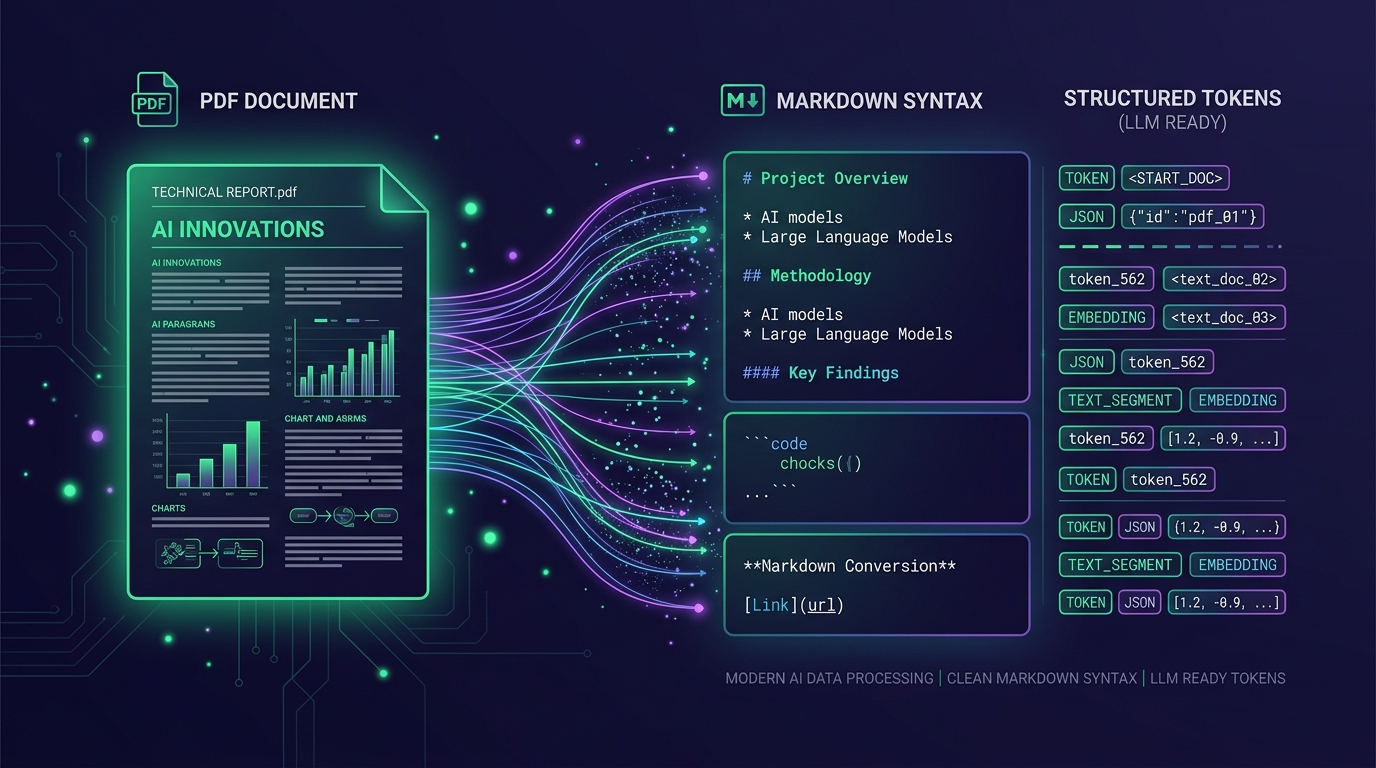
1. 為什麼要把 PDF 轉成 Markdown 服務 LLM 與 Claude 上下文視窗?
PDF 在 1993 年問世,目標是確保螢幕與印表機的視覺一致性,並非為機器智慧而生。PDF 以絕對向量座標(字元的 X、Y 位置)編碼,而不是語意化的文字流。當開發者直接把原始字串或整頁影像丟給前沿 LLM 時,就會碰上嚴重的 Token 膨脹與幻覺問題。
把 PDF 轉成 Markdown 正好解決這些架構瓶頸:剝離表現層中繼資料,並把文件層級提升為輕量、通用可解析的 CommonMark 語法。
1.1 Token 經濟學:上下文開銷降低 75% 到 85%
前沿多模態模型對視覺掃描頁收取高昂的 Token 費用:把 40 頁 PDF 以影像方式傳給 GPT-4o 或 Claude 3.5 Sonnet,在任何指令出現前就消耗 64,000 到 120,000 個 Token。
用 AI 把文件轉成 Markdown 後,同樣 40 頁文件會被壓縮到僅 12,000 到 18,000 個高密度語意 Token。這樣的巨幅縮減避免了上下文視窗耗盡,把推理延遲降低最多 4 倍,並消除不必要的 Token 支出。
1.2 Claude 與 ChatGPT 原生的 Markdown 預訓練
現代基礎模型在網路規模的程式碼、GitHub 儲存庫、技術文件、Wikipedia 上做過大量訓練——這些內容原本就是 Markdown。因此 LLM 對 Markdown 語法擁有內生的結構推理能力。
標題(#、##、###)告訴模型文件層級,無序清單維持群組關係,GitHub Flavored Markdown(GFM)管道表(| Header 1 | Header 2 |)提供明確的行列座標,避免原始文字抽取常見的欄位錯亂。
1.3 為 Claude Projects 與 Artifacts 最佳化 PDF→Markdown
對使用 Claude Projects 或 Claude Artifacts 的 Anthropic 使用者來說,上傳乾淨的 Markdown(.md)而非整塊 PDF,Claude 才能精確地跨文件引用。在大量 RAG 檢索任務中,Claude 也能理解段落邊界,避免「迷失在中段」的現象。
一份 50 頁的複雜財報 PDF 用視覺 Token 攝入約 80,000 個 Token;改用 FileMarkd 轉成乾淨 Markdown 後,同樣內容僅消耗約 13,500 個 Token,Token 節省 83.1%,資料可讀性反而更好。
2. 用 AI 還是傳統 OCR 把 PDF 轉成 Markdown?
多年來,工程師依賴老式 PDF 文字抽取器(如 PyPDF、pdfminer、Poppler)與啟發式 OCR 工具(如 Tesseract)。然而,真實的商業與研究文件往往讓傳統解析器束手無策。
2.1 傳統 PDF 解析器的關鍵缺陷
• 多欄版面錯亂:包含 2~3 欄的學術論文與報紙會被橫向拼接,生成毫無意義的交錯句子。
• 表格關聯流失:表格被壓扁成無序文字片段,儲存格缺漏、標題脫鉤。
• 幻影內容:頁眉、頁尾、頁碼在每一頁重複注入,干擾檢索嵌入。
• 數學符號亂碼:STEM 論文中的希臘字母、積分、分數會變成 Unicode 亂碼。
2.2 視覺語言 AI 模型:真正的語意文件理解
FileMarkd 的 PDF 轉 Markdown 工具等現代文件轉換器把專用視覺骨幹與版面感知 LLM 結合。AI 不再盲目抓取字元,而是分析視覺閱讀順序、辨識表格邊界、抽取 LaTeX 數學公式($$ E = mc^2 $$),並保留程式碼區塊。
透過 AI 理解版面意圖,轉換器輸出乾淨的 CommonMark 與結構化 JSON,忠實還原作者的原始文件結構。
3. 技術比較:PDF 解析方法橫評
為直觀展示常見抽取技術的真實差異,以下對照表比較傳統文字抽取、開源 OCR、原始多模態提示與專用 AI 文件轉換:
不要用固定 500 Token 視窗切塊。改用 Markdown 標題邊界(## 與 ###)切分,確保每個向量塊都包含完整主題,大幅提升相似度檢索的準確率。
| 解析方法 | 表格保留 | 數學/LaTeX | 多欄版型 | Token 效率 | LLM 可用性 |
|---|---|---|---|---|---|
| PyPDF / pdfminer | 差(被壓平) | 破損 | 錯亂 | 中等 | 低(需大量清理) |
| Tesseract OCR | 中等(僅文字) | 無 | 差 | 低(OCR 雜訊) | 低(OCR 錯字) |
| 原始視覺 LLM(逐頁) | 佳 | 佳 | 佳 | 極差(每頁 1.6k+ Token) | 中等(成本過高) |
| FileMarkd AI 引擎 | 完美(GFM 與 JSON) | 原生 LaTeX | 100% 保留 | 優秀(最佳 Markdown) | 高(即可用於 RAG) |
4. 實戰指南:用 FileMarkd 在線把文件轉成 Markdown
不必再糾結於本地命令列依賴、編譯複雜的 OCR 引擎,或寫脆弱的爬蟲腳本;在瀏覽器裡直接把 PDF 轉成 Markdown,無需註冊。
4.1 瀏覽器端快速文件處理
1. 開啟 FileMarkd PDF 轉 Markdown,把 PDF 拖入轉換器。其他格式可用 Word 轉 Markdown 處理 .docx、Excel 轉 Markdown 處理 .xlsx,掃描件與截圖則用 從圖片提取文字。
2. 選擇目標輸出:標準 Markdown(.md)或結構化 JSON(.json)。
3. FileMarkd 版面引擎分析文件層級,辨識標題、巢狀清單與多欄配置。
4. 在原檔頁面旁邊即時預覽渲染後的 Markdown。
4.2 直接匯出到 Claude Projects、ChatGPT 與 AI 筆記本
轉換完成後,你可以下載產生的 `.md` 檔,或按「複製 Markdown」把乾淨文字直接貼到:
• Claude Projects:把 `.md` 檔加入專案知識庫,進行深度多文件綜合。
• ChatGPT 自訂 GPT:作為知識檔上傳,不會超出體積限制。
• NotebookLM 等研究工具:攝取保留引用、表格與章節標題的乾淨文字筆記。
5. Python 資料接入:為 RAG 與向量庫做語意切分
從 FileMarkd 下載轉換後的 Markdown 檔後,接入 Python 的 AI 流程(如 LangChain 或 LlamaIndex)非常直接。Markdown 使用語意標題(#、##、###),可以按邏輯切分,而不是按字數硬切。
5.1 使用 LangChain 按標題切塊
以下範例展示如何載入轉換後的 Markdown 檔,並按標題切成上下文完整的塊,用於向量檢索嵌入:
from langchain.text_splitter import MarkdownHeaderTextSplitter

# 1. 讀取 FileMarkd 產生的 Markdown 檔
with open("annual_financial_report.md", "r", encoding="utf-8") as f:
    markdown_document = f.read()

# 2. 定義標題階層,保留上下文
headers_to_split_on = [
    ("#", "Header_1"),
    ("##", "Header_2"),
    ("###", "Header_3"),
]

markdown_splitter = MarkdownHeaderTextSplitter(
    headers_to_split_on=headers_to_split_on,
    strip_headers=False
)

# 3. 產生語意完整的塊
chunks = markdown_splitter.split_text(markdown_document)

print(f"共產生 {len(chunks)} 個語意塊")
for i, chunk in enumerate(chunks[:2]):
    print(f"--- 第 {i+1} 塊 Metadata: {chunk.metadata} ---")
    print(chunk.page_content[:200] + "...\n")
6. 提示工程:把轉換後的 Markdown 餵給 Claude 與 ChatGPT
由於 Markdown 是乾淨的純文字,你可以把整份轉換後的文件直接嵌入提示範本,不必擔心格式錯亂。
6.1 為 Claude 3.5 Sonnet 使用 XML 標籤組織提示
Anthropic 模型在上下文被明確 XML 標籤包住時表現最佳,這樣可以清楚區隔系統指令與使用者提供的素材:
# 帶乾淨 Markdown 上下文的提示範本
prompt = f"""你是資深研究助理。
請閱讀以下財務文件,僅根據提供的上下文回答使用者問題。

<document format="markdown">
{markdown_document}
</document>

問題:請比較第三季度營業收入與表 2 的預測,列出關鍵差異驅動因素。"""
7. 總結與開始使用
把非結構化 PDF 轉成乾淨的語意化 Markdown,是提升 LLM 上下文視窗、Claude Projects 與 RAG 架構 CP 值最高的最佳化:它降低 Token 消耗、消除多欄版面錯亂造成的幻覺,並保證表格解析萬無一失。
想立刻測試你的文件?試用 FileMarkd PDF 轉 Markdown,免安裝、即時下載。如果還不熟悉這種格式,可以先讀 Markdown 檔案是什麼以及如何打開。
7.1 AI 工程師的關鍵重點
• 別再把 PDF 原始頁面影像直接丟給視覺 LLM,先轉成 Markdown,Token 成本最高省 85%。
• 利用原生 Markdown 管道表與 LaTeX 格式,在財務與 STEM 資料抽取達到 100% 精準。
• 使用語意化 Markdown 標題切塊(##、###),讓向量資料庫索引與檢索準確率顯著提升。