把 PDF 转换为 Markdown 给 AI 使用 —— ChatGPT、Claude 与大语言模型
直接把 PDF 原文件、噪点文本喂给大语言模型(LLM),会显著降低准确率、浪费高达 85% 的上下文 Token 预算,并把表格与公式搅乱。把 PDF 转换为 Markdown 后,你会得到干净、语义清晰的多栏文档结构,Claude 3.5 Sonnet、ChatGPT(GPT-4o)与本地大模型都能原生理解。本篇完整工程指南讲解如何使用 AI 把文档转换为 Markdown,以及为什么 Claude 与 LLM 在 Markdown 结构下表现更佳,并教你为 AI 工作流准备高准确度的文档语料。
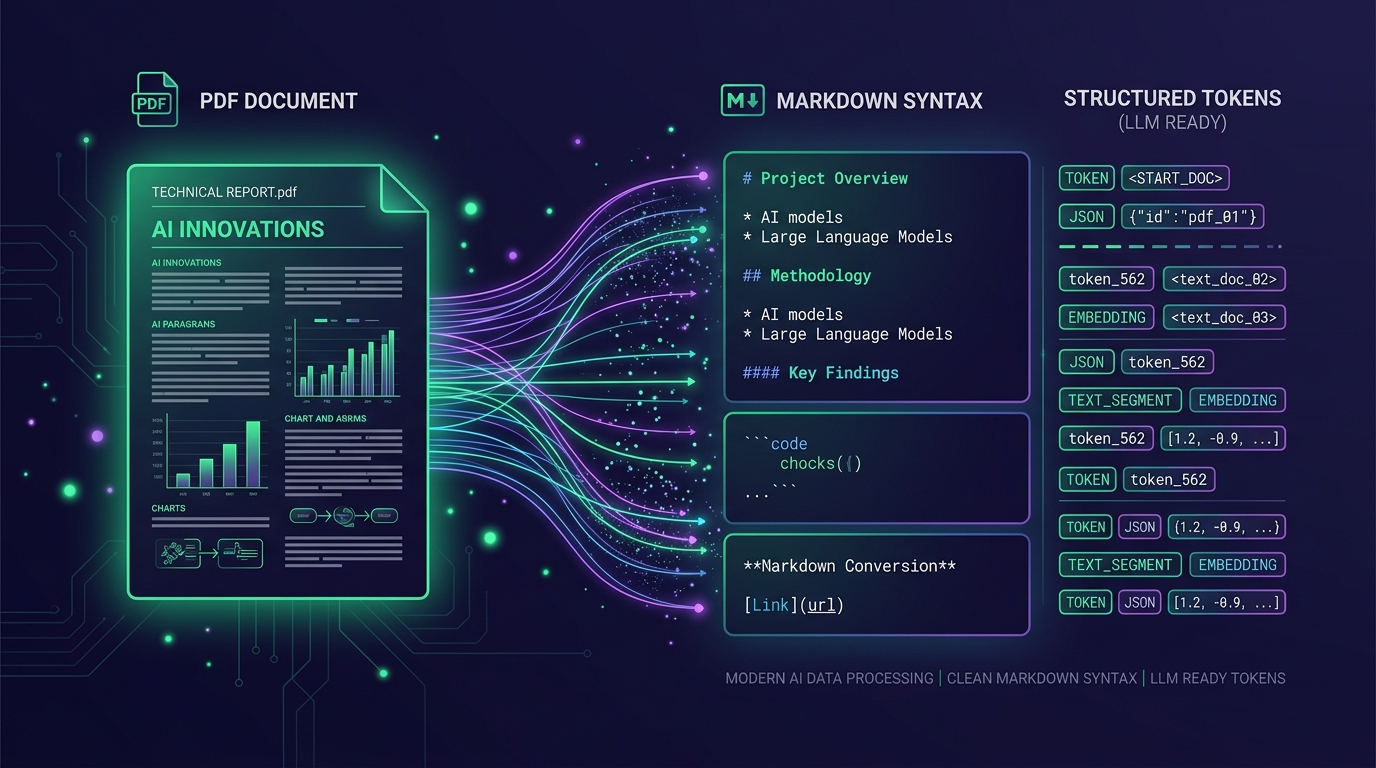
1. 为什么把 PDF 转换为 Markdown 服务于 LLM 与 Claude 上下文窗口?
PDF 诞生于 1993 年,目标是保证屏幕和打印机的视觉一致性,而非服务于机器智能。PDF 使用绝对矢量坐标(字符的 X、Y 位置)来编码,而非语义化的文本流。当开发者直接把原始字符串或整页图像喂给前沿 LLM 时,会遭遇严重的 Token 膨胀与幻觉问题。
把 PDF 转换为 Markdown 正好解决这些架构瓶颈:剥离表现层元数据,同时把文档层级提升为轻量、通用可解析的 CommonMark 语法。
1.1 Token 经济性:上下文开销减少 75% 至 85%
前沿多模态模型对视觉扫描页收取高昂的 Token 费用:把 40 页 PDF 作为图像传给 GPT-4o 或 Claude 3.5 Sonnet,在任何指令出现前就消耗 64,000 至 120,000 个 Token。
使用 AI 把文档转换为 Markdown 后,同样的 40 页文档被压缩到仅 12,000 至 18,000 个高密度语义 Token。这一巨幅缩减避免了上下文窗口耗尽,把推理延迟降低最多 4 倍,并消除不必要的 Token 开支。
1.2 Claude 与 ChatGPT 的原生 Markdown 预训练
现代基础模型在互联网规模的代码库、GitHub 仓库、技术文档、Wikipedia 上进行过大量训练——这些内容天然以 Markdown 存储。因此,LLM 对 Markdown 语法具备内生的结构推理能力。
标题(#、##、###)告诉模型文档层级,无序列表维持分组关系,GitHub Flavored Markdown(GFM)管道表(| Header 1 | Header 2 |)提供显式的行列坐标感知,避免原始文本抽取常见的列错乱。
1.3 为 Claude Projects 与 Artifacts 优化 PDF→Markdown
对于使用 Claude Projects 或 Claude Artifacts 的 Anthropic 用户,上传干净的 Markdown(.md)文件而非整块 PDF,可以让 Claude 精确地进行跨文档引用。Claude 能理解段落边界,在大量 RAG 检索任务中避免「迷失在中间」现象。
一份 50 页的复杂财报 PDF 以视觉 Token 摄入约 80,000 个 Token;使用 FileMarkd 转为干净 Markdown 后,同样内容仅消耗约 13,500 个 Token,Token 节省 83.1%,数据可读性反而更强。
2. 使用 AI 还是传统 OCR 把 PDF 转换为 Markdown?
多年来,工程师依赖老式 PDF 文本抽取器(如 PyPDF、pdfminer、Poppler)以及启发式 OCR 工具(如 Tesseract)。然而,真实业务与研究文档往往让传统解析器束手无策。
2.1 传统 PDF 解析器的关键缺陷
• 多栏版面错乱:包含 2~3 栏的学术论文与报纸会被横向拼接,生成毫无意义的交错句子。
• 表格关联丢失:表格被压平成无序文本片段,缺单元格、表头脱节。
• 幻影内容:页眉、页脚、页码在每一页重复注入,扰乱检索嵌入。
• 数学符号乱码:STEM 论文中的希腊字母、积分、分数会变成 Unicode 乱码。
2.2 视觉语言 AI 模型:真正的语义文档理解
FileMarkd 的 PDF 转 Markdown 工具等现代文档转换器把专用的视觉骨干与版面感知 LLM 结合。AI 不再盲目抓取字符,而是分析视觉阅读顺序、识别表格边界、抽取 LaTeX 数学公式($$ E = mc^2 $$),并保留代码块。
通过 AI 理解版面意图,转换器输出干净的 CommonMark 与结构化 JSON,忠实还原作者的原始文档结构。
3. 技术对照:PDF 解析方法横评
为了直观展现常见抽取技术的真实表现差异,以下对照表对比了传统文本抽取、开源 OCR、原始多模态提示以及专用 AI 文档转换:
不要按固定的 500 Token 窗口切分文档。改用 Markdown 标题边界(## 与 ###)切分,保证每个向量块都包含完整主题,显著提升相似度检索的准确率。
| 解析方法 | 表格保留 | 数学/LaTeX | 多栏版式 | Token 效率 | LLM 可用性 |
|---|---|---|---|---|---|
| PyPDF / pdfminer | 差(被压平) | 破损 | 错乱 | 一般 | 低(需要大量清理) |
| Tesseract OCR | 一般(仅文本) | 无 | 差 | 低(OCR 噪点) | 低(OCR 错字) |
| 原始视觉 LLM(逐页) | 好 | 好 | 好 | 极差(每页 1.6k+ Token) | 中等(成本过高) |
| FileMarkd AI 引擎 | 完美(GFM 与 JSON) | 原生 LaTeX | 100% 保留 | 优秀(最优 Markdown) | 高(RAG 即可用) |
4. 实战指南:使用 FileMarkd 在线把文档转换为 Markdown
不必再纠结本地命令行依赖、编译复杂的 OCR 引擎或写脆弱的抓取脚本,在浏览器里直接把 PDF 转换为 Markdown,无需注册。
4.1 浏览器端快速文档处理
1. 打开 FileMarkd PDF 转 Markdown,把 PDF 拖入转换器。其他格式可用 Word 转 Markdown 处理 .docx、Excel 转 Markdown 处理 .xlsx,扫描件与截图则用 从图片提取文本。
2. 选择目标输出:标准 Markdown(.md)或结构化 JSON(.json)。
3. FileMarkd 版面引擎分析文档层级,识别标题、嵌套列表与多栏布局。
4. 在原文档页面旁同步预览渲染后的 Markdown。
4.2 直接导出到 Claude Projects、ChatGPT 与 AI 笔记本
转换完成后,你可以下载生成的 `.md` 文件,或点击「复制 Markdown」把干净文本直接粘贴到:
• Claude Projects:把 `.md` 文件加入项目知识库,进行深度多文档综合。
• ChatGPT 自定义 GPT:作为知识文件上传,不超出上传体积限制。
• NotebookLM 等研究工具:摄取保留引用、表格与章节标题的干净文本笔记。
5. Python 数据接入:为 RAG 与向量库做语义切分
从 FileMarkd 下载转换后的 Markdown 文件后,接入 Python 的 AI 流水线(如 LangChain 或 LlamaIndex)非常直接。Markdown 使用语义标题(#、##、###),可以按逻辑切分,而不是按字数硬切。
5.1 使用 LangChain 按标题切分
下面示例演示如何加载转换后的 Markdown 文件,并按标题切分为上下文完整的块,用于向量检索嵌入:
from langchain.text_splitter import MarkdownHeaderTextSplitter

# 1. 读取 FileMarkd 生成的 Markdown 文件
with open("annual_financial_report.md", "r", encoding="utf-8") as f:
    markdown_document = f.read()

# 2. 定义标题层级,保留上下文
headers_to_split_on = [
    ("#", "Header_1"),
    ("##", "Header_2"),
    ("###", "Header_3"),
]

markdown_splitter = MarkdownHeaderTextSplitter(
    headers_to_split_on=headers_to_split_on,
    strip_headers=False
)

# 3. 生成语义完整的块
chunks = markdown_splitter.split_text(markdown_document)

print(f"已生成 {len(chunks)} 个语义块")
for i, chunk in enumerate(chunks[:2]):
    print(f"--- 第 {i+1} 块 Metadata: {chunk.metadata} ---")
    print(chunk.page_content[:200] + "...\n")
6. 提示工程:把转换后的 Markdown 喂给 Claude 与 ChatGPT
由于 Markdown 是干净的纯文本,你可以把整份转换后的文档直接嵌入提示模板,无需担心格式错乱。
6.1 为 Claude 3.5 Sonnet 使用 XML 标签组织提示
Anthropic 模型在上下文被显式 XML 标签包裹时表现最佳,这样可以清晰区分系统指令与用户提供的素材:
# 带干净 Markdown 上下文的提示模板
prompt = f"""你是一名资深研究助理。
请阅读下面的财务文件,仅根据提供的上下文回答用户问题。

<document format="markdown">
{markdown_document}
</document>

问题:请对比第三季度营业收入与表 2 中的预测,列出关键差异驱动因素。"""
7. 总结与开始使用
把非结构化 PDF 转换为干净的语义化 Markdown,是提升 LLM 上下文窗口、Claude Projects 与 RAG 架构性价比最高的优化:它降低 Token 消耗、消除多栏布局错乱导致的幻觉,并保证表格解析万无一失。
想立刻测试你的文档?试用 FileMarkd PDF 转 Markdown,免安装、即时下载。如果还不熟悉这种格式,可以先读 Markdown 文件是什么以及如何打开。
7.1 AI 工程师的关键要点
• 不要再把 PDF 原始页面图像直接发给视觉 LLM,先转换为 Markdown,Token 成本最高可省 85%。
• 利用原生 Markdown 管道表与 LaTeX 格式,在财务与 STEM 数据抽取中实现 100% 精度。
• 使用语义化 Markdown 标题切分(##、###),让向量数据库索引与检索准确率显著提升。