PDF を Markdown に変換して AI(ChatGPT・Claude・LLM)で使う
生の PDF やノイズだらけのテキストをそのまま LLM に渡すと、精度が落ち、最大 85% のコンテキストウィンドウを浪費し、表や数式がぐちゃぐちゃになります。PDF を Markdown に変換すると、複数カラム構成の複雑な文書がクリーンで意味的な構文になり、Claude 3.5 Sonnet、ChatGPT(GPT-4o)、ローカル LLM がネイティブに理解できます。本ガイドでは、AI で文書を Markdown に変換する方法、Claude や LLM が Markdown 構造を好む理由、そして AI ワークフロー向けの高精度ドキュメントコーパスの作り方を包括的に説明します。
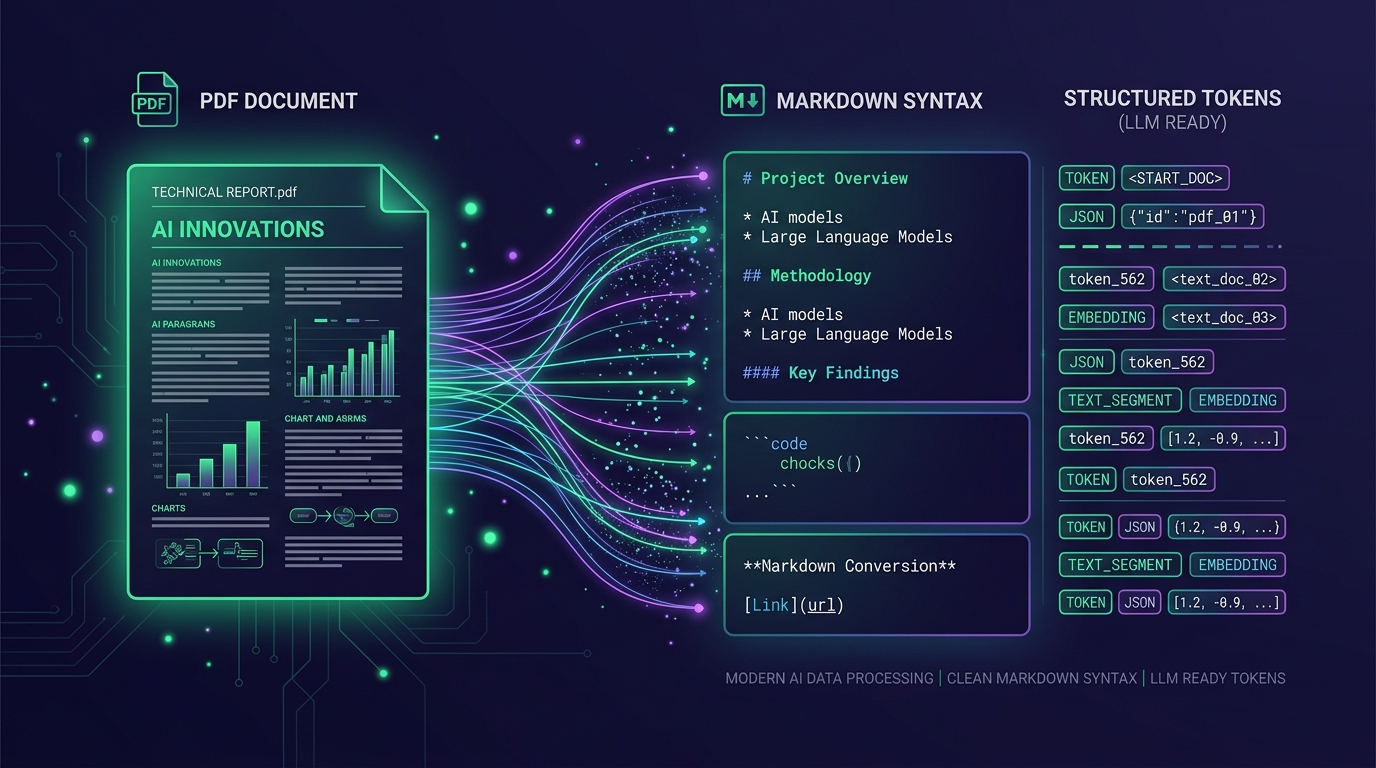
1. なぜ LLM・Claude のために PDF を Markdown に変換するのか?
PDF は 1993 年に、画面や印刷機での見た目の忠実性を目的として設計されました。機械知能向けではありません。PDF は文字の X・Y 座標のような絶対ベクトル座標でエンコードされており、意味的なテキストフローではありません。開発者が生の文字列を抽出したり、ページ画像ごと LLM に渡したりすると、Token の肥大化と幻覚が深刻になります。
PDF → Markdown 変換は、表現メタデータをそぎ落としつつ、文書階層を軽量で汎用的にパース可能な CommonMark へ昇格させることで、これらの根本的なボトルネックを解消します。
1.1 Token 経済:コンテキストコストを 75〜85% 削減
最先端のマルチモーダルモデルは、ビジュアルなページスキャンに対して高い Token 課金をします。40 ページの PDF を画像として GPT-4o や Claude 3.5 Sonnet に送ると、プロンプト指示より前に 64,000〜120,000 Token を消費します。
AI で同じ 40 ページを Markdown に変換すると、わずか 12,000〜18,000 Token の高密度テキストへ圧縮されます。これにより、コンテキストウィンドウの枯渇を防ぎ、推論レイテンシを最大 4 倍短縮し、不要な Token 支出を排除できます。
1.2 Claude と ChatGPT のネイティブ Markdown 事前学習
現代の基盤モデルは、インターネット規模のコードベース、GitHub リポジトリ、技術ドキュメント、Wikipedia など、Markdown で記述されたデータで大量に学習されています。そのため、LLM は Markdown 構文に対してネイティブな構造的推論を持ちます。
見出し(#、##、###)は階層を、箇条書きは分類関係を、GitHub Flavored Markdown(GFM)のパイプテーブル(| Header 1 | Header 2 |)は行・列の座標を明示し、生文字列抽出で頻発するカラム崩れエラーを防ぎます。
1.3 Claude Projects / Artifacts に向けた最適化
Claude Projects や Artifacts を利用する Anthropic ユーザーにとって、巨大な PDF ではなくクリーンな Markdown(.md)をアップロードすると、Claude は引用を精緻にクロスリファレンスできます。セクション境界を理解するため、大規模な RAG クエリでも「lost in the middle」現象を回避できます。
50 ページの複雑な財務 PDF をビジョン Token で投入すると約 80,000 Token。FileMarkd でクリーンな Markdown に変換すれば、同じ内容でわずか約 13,500 Token で済み、83.1% の Token を節約しつつ理解度も向上します。
2. AI 変換 vs 従来 OCR:PDF を Markdown にする方法
長らく、エンジニアはレガシー PDF テキスト抽出器(PyPDF、pdfminer、Poppler など)や、ヒューリスティックな OCR(Tesseract など)に頼ってきました。しかし、実務のビジネス文書や研究文書はこれらの従来パーサーを壊します。
2.1 レガシー PDF パーサーの致命的欠陥
• 複数カラムの崩落:2〜3 段組の論文や新聞が横方向で結合され、意味不明な交差文になる。
• 表の関連崩壊:表がデタラメなテキスト断片へ平坦化され、セル抜けやヘッダー脱落が発生。
• ファントムアーティファクト:ヘッダー、フッター、ページ番号が全ページに重複注入され、検索埋め込みを惑わせる。
• 数式記号の崩壊:STEM 論文中のギリシャ文字・積分・分数が Unicode のガラクタに化ける。
2.2 ビジョン・ランゲージ AI:意味的文書理解
FileMarkd の PDF → Markdown 変換ツールのような最新コンバーターは、専門的なビジョンバックボーンとレイアウト認識 LLM を組み合わせます。AI は盲目的な文字抽出ではなく、視覚的読書順を解析し、表の境界を認識し、LaTeX 数式($$ E = mc^2 $$)を抽出し、コードブロックを保持します。
レイアウト意図を理解する AI によって、クリーンな CommonMark と構造化 JSON が出力され、元の文書構造を忠実に再現します。
2.3 大規模に混在文書を Markdown へ
現代の RAG アーキテクチャが扱うのは PDF だけではありません。企業リポジトリには Word(.docx)、PowerPoint(.pptx)、Excel(.xlsx)、スキャンされた TIFF/JPEG フォームなどが含まれます。最新の AI 変換パイプラインは、これら全ての異種ソースを統一された Markdown スキーマへ正規化し、埋め込みモデルのための標準化されたインジェクションベクトルを作ります。
画像だけの素材も同じビジョンパイプラインを通します。ただしドキュメントのラッパーは不要です。PNG → テキスト と 画像からテキストを抽出 は、図表・ホワイトボードのエクスポート・撮影した紙面をそのまま Markdown として読み取ります。
3. 技術ベンチマーク:PDF 解析手法の比較
現実の差を明らかにするため、伝統的なテキスト抽出、オープンソース OCR、生のマルチモーダル呼び出し、専用 AI 変換を比較したベンチマークを示します。
500 Token 固定窓で分割するのは避け、Markdown 見出し境界(##、###)で分割しましょう。概念単位がベクトルチャンク内で丸ごと保たれ、類似検索の再現率が劇的に向上します。
| 解析手法 | テーブル保持 | 数式 / LaTeX | 複数カラム | Token 効率 | LLM 適合度 |
|---|---|---|---|---|---|
| PyPDF / pdfminer | 不適(平坦化) | 壊れる | 崩壊 | 中 | 低(重い後処理が必要) |
| Tesseract OCR | 中(テキストのみ) | なし | 不適 | 低(OCR ノイズ) | 低(OCR 誤字) |
| 生ビジョン LLM(ページごと) | 良 | 良 | 良 | 極低(ページあたり 1.6k+ Token) | 中(費用対効果低) |
| FileMarkd AI エンジン | 完璧(GFM & JSON) | ネイティブ LaTeX | 100% 保持 | 優秀(最適化 Markdown) | 高(RAG 即対応) |
4. 実践ガイド:FileMarkd でオンライン文書→Markdown
ローカル CLI 依存や複雑な OCR エンジンのビルド、壊れやすいスクレイピングを書く必要はありません。ブラウザで PDF を Markdown に変換するだけで完了し、登録も不要です。
4.1 ブラウザで高速処理
1. FileMarkd の PDF → Markdown 変換ツールを開き、PDF をドラッグ&ドロップ。他の形式は Word → Markdown(.docx)、Excel → Markdown(.xlsx)、スキャン画像やスクリーンショットは画像からテキストを抽出どうぞ。
2. 出力フォーマットを「標準 Markdown(.md)」または「構造化 JSON(.json)」から選択。
3. FileMarkd のレイアウトエンジンが見出し、入れ子のリスト、複数カラムを解析。
4. 原文ページと並べてレンダリング結果をリアルタイムにプレビュー。
4.2 Claude Projects・ChatGPT・AI ノートへ直接出力
変換完了後、生成された `.md` をダウンロード、もしくは「Copy Markdown」をクリックしてクリーンなテキストを即貼り付けできます。
• Claude Projects:`.md` をナレッジベースに追加し、複数文書を深く統合。
• ChatGPT カスタム GPT:ナレッジファイルとしてアップロード。サイズ上限を気にせず登録可能。
• NotebookLM などの研究ツール:引用・表・章タイトルを保ったクリーンなノートを取り込み。
5. Python データ投入:RAG 用の意味的チャンク化
FileMarkd で変換した Markdown をダウンロードしたら、Python の AI パイプライン(LangChain、LlamaIndex など)への取り込みもクリーンです。Markdown は意味的な見出し(#、##、###)を持つため、文字数固定ではなく論理単位で分割できます。
5.1 LangChain でヘッダー単位に分割
変換済み Markdown を読み込み、ベクトル検索用にコンテキスト豊富なチャンクへ分割する例です。
from langchain.text_splitter import MarkdownHeaderTextSplitter

# 1. FileMarkd が生成した Markdown を読み込む
with open("annual_financial_report.md", "r", encoding="utf-8") as f:
    markdown_document = f.read()

# 2. コンテキストを保つための見出し階層を定義
headers_to_split_on = [
    ("#", "Header_1"),
    ("##", "Header_2"),
    ("###", "Header_3"),
]

markdown_splitter = MarkdownHeaderTextSplitter(
    headers_to_split_on=headers_to_split_on,
    strip_headers=False
)

# 3. 意味的に完全なチャンクを生成
chunks = markdown_splitter.split_text(markdown_document)

print(f"生成された意味的チャンク数: {len(chunks)}")
for i, chunk in enumerate(chunks[:2]):
    print(f"--- チャンク {i+1} メタデータ: {chunk.metadata} ---")
    print(chunk.page_content[:200] + "...\n")
6. プロンプト設計:変換済み Markdown を Claude・ChatGPT へ
Markdown はクリーンなプレーンテキストなので、変換済みドキュメント全体をプロンプトへ直接埋め込んでもフォーマットが壊れません。
6.1 Claude 3.5 Sonnet 向けに XML タグで構造化
Anthropic のモデルはコンテキストが XML タグで明示的に囲まれているときに最高性能を発揮します。システム指示とユーザー資料を明確に分離できます。
# クリーンな Markdown コンテキストを使ったプロンプトテンプレート
prompt = f"""あなたは熟練したリサーチアナリストです。
以下の財務文書を読み、ユーザーが尋ねた問いに対し、提供されたコンテキストのみに基づいて正確に回答してください。

<document format="markdown">
{markdown_document}
</document>

問い:第 3 四半期の営業収益を表 2 の見通しと比較し、主要な差異要因を列挙してください。"""
7. まとめ&はじめ方
非構造化 PDF を意味的な Markdown に変換することは、LLM のコンテキストウィンドウ・Claude Projects・RAG アーキテクチャに対する最も ROI の高い最適化です。Token 支出を削減し、複数カラムの崩壊による幻覚を一掃し、表のパースを完全に保証します。
いますぐ試すならFileMarkd の PDF → Markdown 変換ツール。ブラウザだけでクリーンな Markdown を取得でき、インストール不要・即ダウンロードです。形式に迷ったらまずMarkdown ファイルとはをご覧ください。
7.1 AI エンジニア向け重要ポイント
• PDF のページ画像をそのままビジョン LLM に投げず、まず Markdown に変換して Token コストを最大 85% 削減。
• Markdown のネイティブパイプテーブルと LaTeX 表記を活用し、財務・STEM データの抽出を 100% 精度に。
• 意味的な Markdown ヘッダー(##、###)で分割し、ベクトル DB のインデックスと検索精度を底上げ。